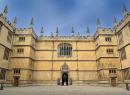
Оксфордский университет разрешил компании, создавшей ChatGPT, использовать исторические тексты из своей Бодлианской библиотеки для обучения моделей искусственного
интеллекта, поскольку технологические компании активно ищут новые данные в академических учреждениях. Согласно внутренним документам, материалы Бодлианской библиотеки, оцифрованные OpenAI, были использованы для «наполнения обучающего набора данных OpenAI».
Оксфорд объявил о партнерстве с этой компанией в марте 2025 года; в рамках сотрудничества для оцифровки текстов из всемирно известной университетской библиотеки использовалось программное обеспечение OpenAI, что, по заявлению университета, должно было сделать материалы более доступными для студентов и исследователей. Однако в официальном сообщении не упоминалось, что эти материалы будут использоваться для обучения моделей OpenAI. Такие модели обучаются распознавать языковые закономерности — и, следовательно, «учатся» составлять полные предложения и выполнять другие когнитивные задачи — путем обработки огромных массивов данных. Представитель OpenAI заявил, что компания «гордится» тем, что помогает «современным моделям ИИ сохранять мировые исторические знания для будущего».
«Поскольку этой технологией в повседневной жизни пользуются более миллиарда человек, важно, чтобы она отражала разнообразие культур, исторических событий и точек зрения», — добавили в компании. В протоколах заседаний Оксфордского университета, полученных по запросу о свободе доступа к информации, зафиксированы опасения сотрудников (в том числе членов управляющего комитета Бодлианской библиотеки) касательно репутационных рисков партнерства с OpenAI.
Также обсуждалось влияние сделки, связанной с энергоемкой технологией, на выполнение университетом своих обязательств в сфере защиты окружающей среды. Книготорговцы также сообщают о всплеске заказов на малоизвестные издания — например, на справочники по сельскохозяйственным орудиям в Африке XVIII века или биографии автогонщиков 1950-х годов. Владельцы букинистических магазинов предполагают, что, поскольку такие книги вряд ли существуют в цифровом виде в интернете, они представляют собой ценный источник новых данных для обучения ИИ-моделей следующего поколения. Веб-сайты, данные с которых собираются для обучения ИИ, всё больше заполняются контентом, созданным самим же искусственным интеллектом, что снижает их ценность для обучения моделей; в связи с этим разработчики обратились к физическим — и зачастую историческим — книжным собраниям.
Компания OpenAI заключила аналогичные соглашения с такими американскими исследовательскими библиотеками, как Бостонская публичная библиотека, Калифорнийский технологический институт (Caltech), Массачусетский технологический институт (MIT) и Мичиганский университет, в рамках проекта NextGenAI. Оксфордский университет — единственный участник этого проекта из Великобритании. К июню 2025 года OpenAI получила из фондов Бодлианской библиотеки 125 000 изображений, полученных путем сканирования исторических диссертаций, в том числе докторских работ, написанных в университетах Европы и США в XIX и XX веках. Среди других отсканированных материалов — редкая коллекция из 10 000 «уличных баллад» (broadside ballads) XVI века, содержащих тексты песен и ноты (когда-то эти листки распространялись на перекрестках городов в эпоху Тюдоров). Сотрудники также обсуждали оцифровку ирландских государственных документов XVIII века, личной переписки ирландской писательницы Марии Эджуорт и рабочих записей Дороти Ходжкин, посвященных исследованиям пенициллина.
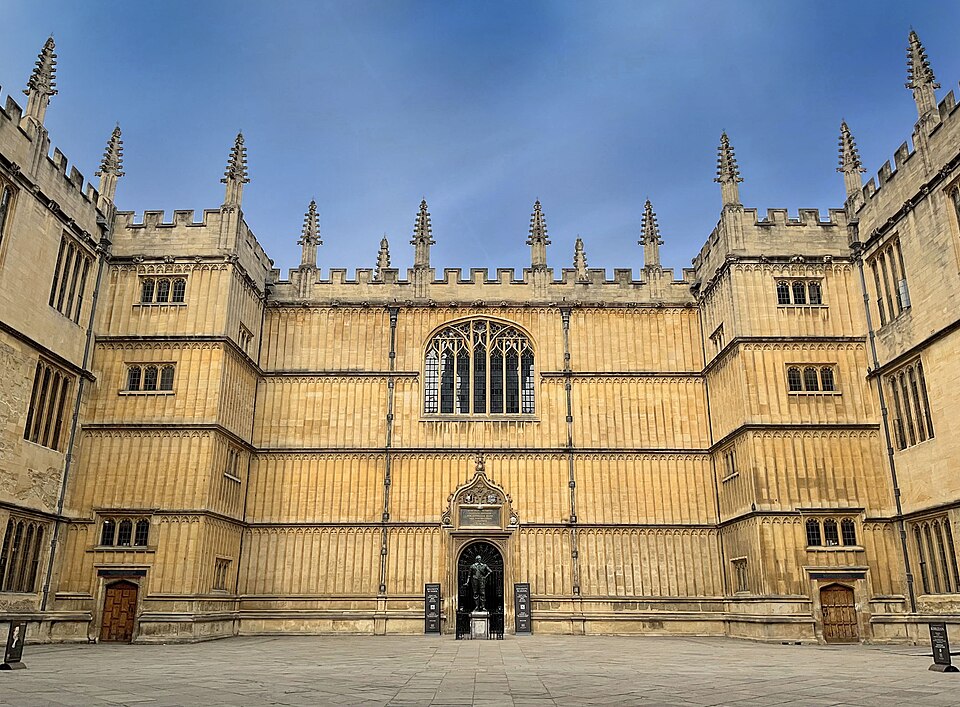
Контракт OpenAI с Оксфордом также открывает перспективу масштабной оцифровки всего собрания Бодлианской библиотеки, насчитывающего 23 миллиона единиц хранения. В протоколах обсуждений также упоминалось создание чат-бота под названием «Ask the Bod» («Спроси Бодлианскую»). Представитель Оксфордского университета заявил, что объем оцифровываемых текстов «невелик» и касается только материалов, на которые больше не распространяется авторское право. По словам представителя, права на полученные сканы остаются за Бодлианской библиотекой, и в ближайшие месяцы она начнет публиковать их в открытом доступе в интернете (фото-Honcques Laus/wikimedia).